Автоматичне формування FAIR-метаданих DFT-розрахунку Quantum ESPRESSO: MATSCI-NASU DFT Extractor
MATSCI-NASU DFT Extractor v0.1 автоматично перетворює файли одного Quantum ESPRESSO pw.x-розрахунку на структурований FAIR-oriented metadata package. Інструмент читає input/output, XML та UPF, витягує параметри DFT, результати й технічний provenance та формує canonical MATSCI record, MatCore-oriented metadata, manifest і checksums.
Тип: Manual
Topics
- FAIR data
- EOSC
- Metadata
- DMP
- Quantum ESPRESSO
- Materials workflows
- Pilot chains
Audience
- Researchers
- Data stewards
Від файлів pw.x до структурованого FAIR-пакета
Розрахунок методом теорії функціонала густини, або Density Functional Theory (DFT), зазвичай завершується набором технічних файлів: вхідним файлом програми, текстовим output, файлами псевдопотенціалів та внутрішніми файлами розрахункового пакета. Для самого дослідника цього часто достатньо, щоб продовжити обчислення або підготувати наукову публікацію. Для повторного використання результатів іншими дослідниками, автоматизованого аналізу, включення до репозитарію або використання у наступних обчислювальних етапах цього вже недостатньо.
FAIR-представлення DFT-розрахунку потребує відповіді щонайменше на чотири питання: яка система розраховувалася; який метод і параметри були використані; які саме файли та псевдопотенціали брали участь у розрахунку; які результати були отримані і чи завершився розрахунок коректно.
Чому метадані можна формувати автоматично
Значна частина необхідної інформації вже міститься у файлах Quantum ESPRESSO і тому не повинна повторно вводитися дослідником вручну. pw.x використовує структуровані namelists і cards для опису calculation task, структури, cutoff energies, k-point grid, SCF settings, spin parameters та pseudopotentials.
Після виконання розрахунку Quantum ESPRESSO створює також структурований XML output. Окремим джерелом метаданих є файли UPF, у яких зберігається інформація про псевдопотенціали.
Принцип роботи extractor полягає в тому, що computational artefacts використовуються як первинне джерело технічних метаданих. Дослідник не переписує вручну параметри розрахунку: extractor читає їх із файлів, нормалізує і формує структурований metadata record.
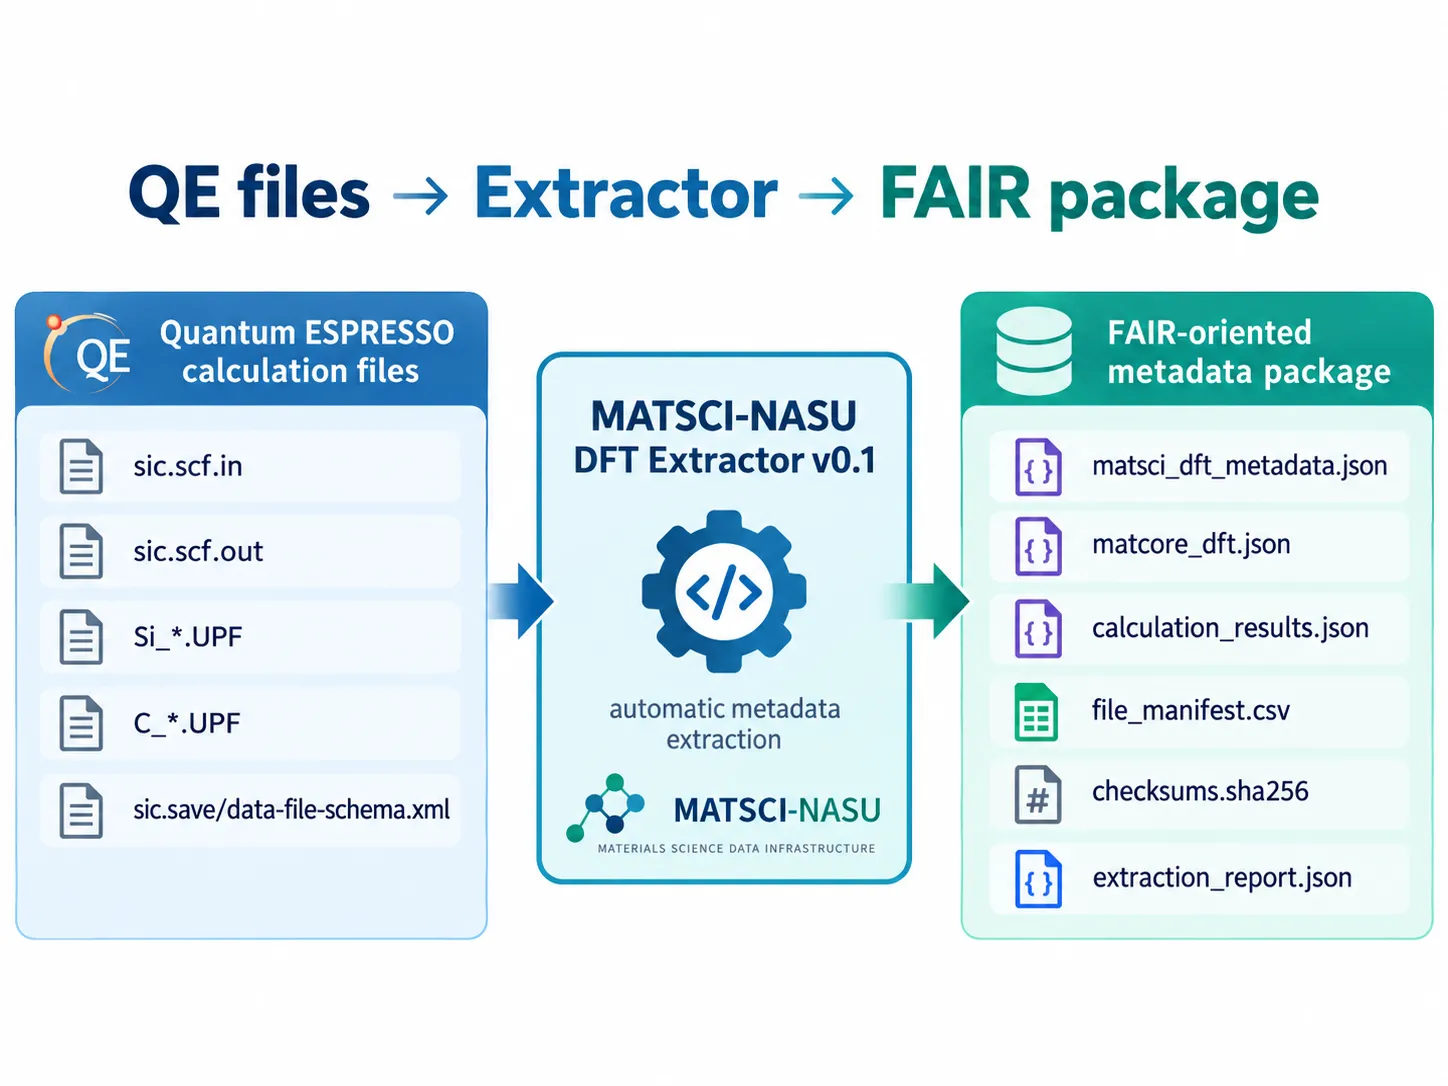
Рис. 1. Загальна схема роботи MATSCI-NASU DFT Extractor: від файлів Quantum ESPRESSO до FAIR-oriented metadata package.
Які файли потрібні
Найповніший пакет одного DFT-розрахунку містить input, output, використані pseudopotentials та каталог prefix.save зі структурованим XML Quantum ESPRESSO.
Extractor може працювати і з неповним набором файлів, але повнота метаданих буде нижчою.
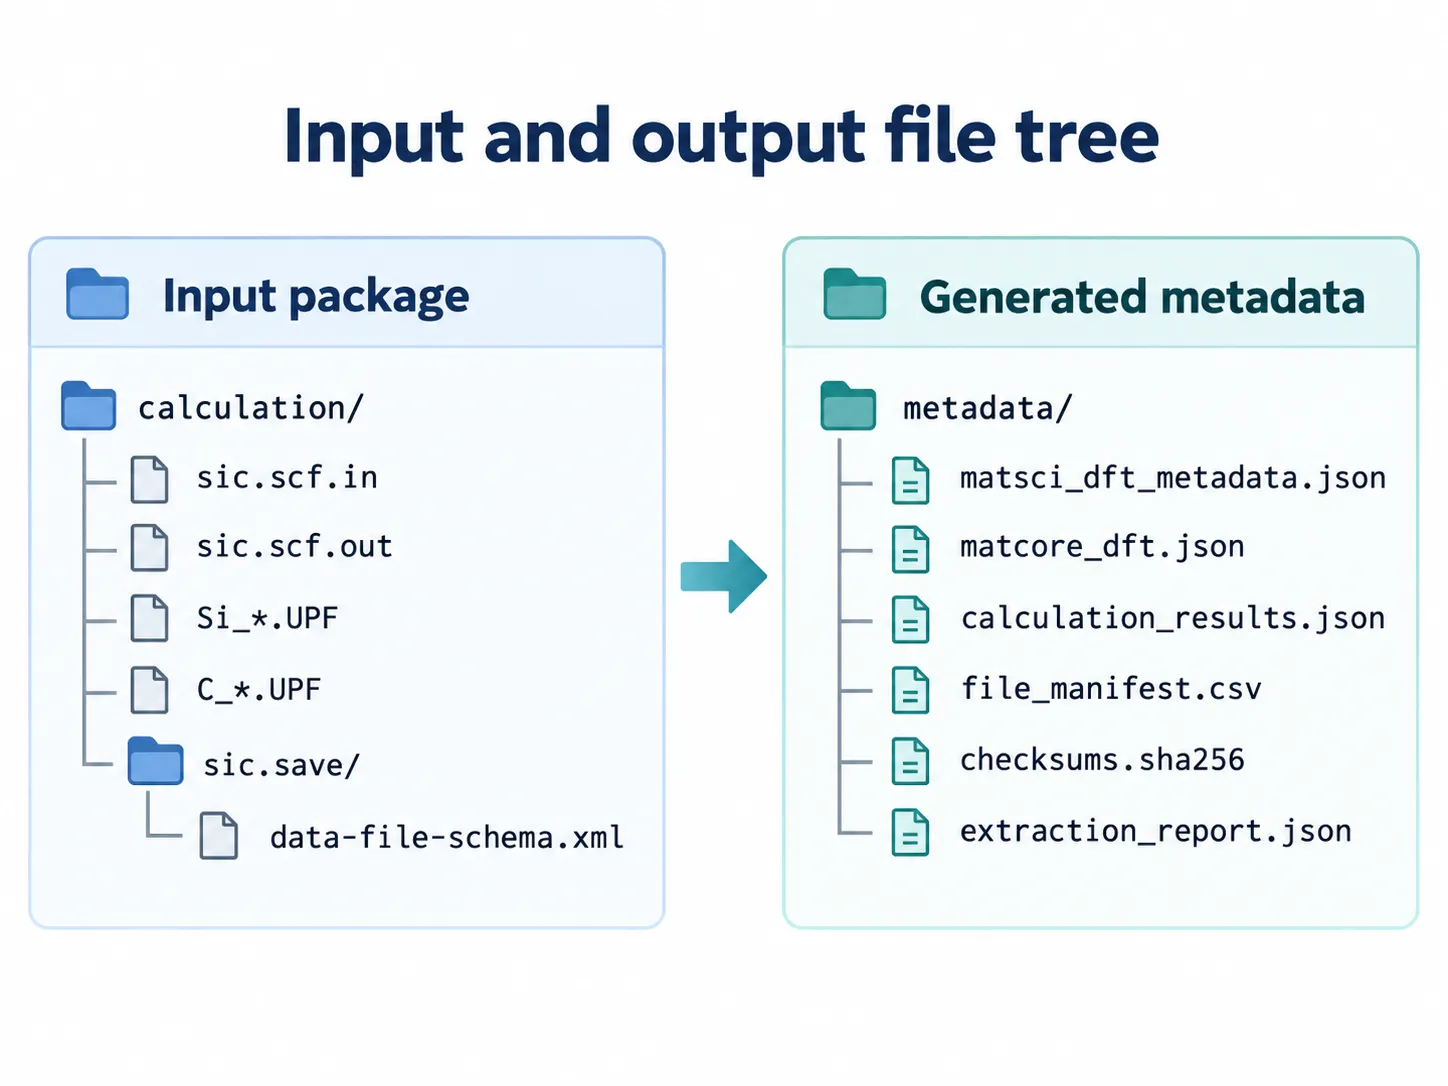
Рис. 2. Структура вхідного пакета Quantum ESPRESSO та файлів метаданих, які формує MATSCI-NASU DFT Extractor.
Вхідний файл використовується насамперед для requested settings та initial structure. Output дає version Quantum ESPRESSO, convergence information і чисельні результати. XML є структурованим джерелом effective і final values, а UPF-файли містять intrinsic metadata pseudopotentials.
Особливо важливо розрізняти requested та effective values. Параметр може бути не заданий у input, але Quantum ESPRESSO застосує default value. Для відтворюваності необхідно зафіксувати значення, яке реально було використано.
Що саме витягує DFT Extractor
MATSCI-NASU DFT Extractor v0.1 формує metadata record з кількох логічних блоків.
Перший блок описує calculation і software: тип задачі, локальний identifier, Quantum ESPRESSO та його version.
Другий блок описує структуру: atomic species, atomic positions, lattice parameters і unit cell.
Третій блок містить DFT setup: exchange-correlation description, ecutwfc, ecutrho, k-point settings, occupations, smearing, spin settings і SCF parameters.
Четвертий блок описує pseudopotentials, включно з файлами та SHA-256.
П’ятий блок містить результати: total energy, Fermi energy, forces, pressure та інші величини, якщо вони присутні у calculation output.
Окремий quality_control block показує, чи завершився calculation, чи досягнута convergence і які джерела метаданих були доступні.
Що створюється після запуску
Основним результатом роботи extractor є файл matsci_dft_metadata.json. Він використовується як canonical metadata record MATSCI-NASU.
Окремо створюються MatCore-oriented projection, calculation results, manifest усіх файлів, SHA-256 checksums та extraction report.
Нормалізація одиниць
Quantum ESPRESSO використовує Rydberg atomic units, тоді як зовнішні metadata standards можуть вимагати інші одиниці. Тому extractor зберігає як оригінальне значення, так і нормалізоване.
Наприклад: (JSON)
"ecutwfc": {
  "source_value": 40.0,
  "source_unit": "Ry",
  "normalized_value": 544.2277,
  "normalized_unit": "eV"
}
Це дозволяє зберегти точне значення, яке використовувалося Quantum ESPRESSO, і водночас підготувати дані для machine-readable interoperability.
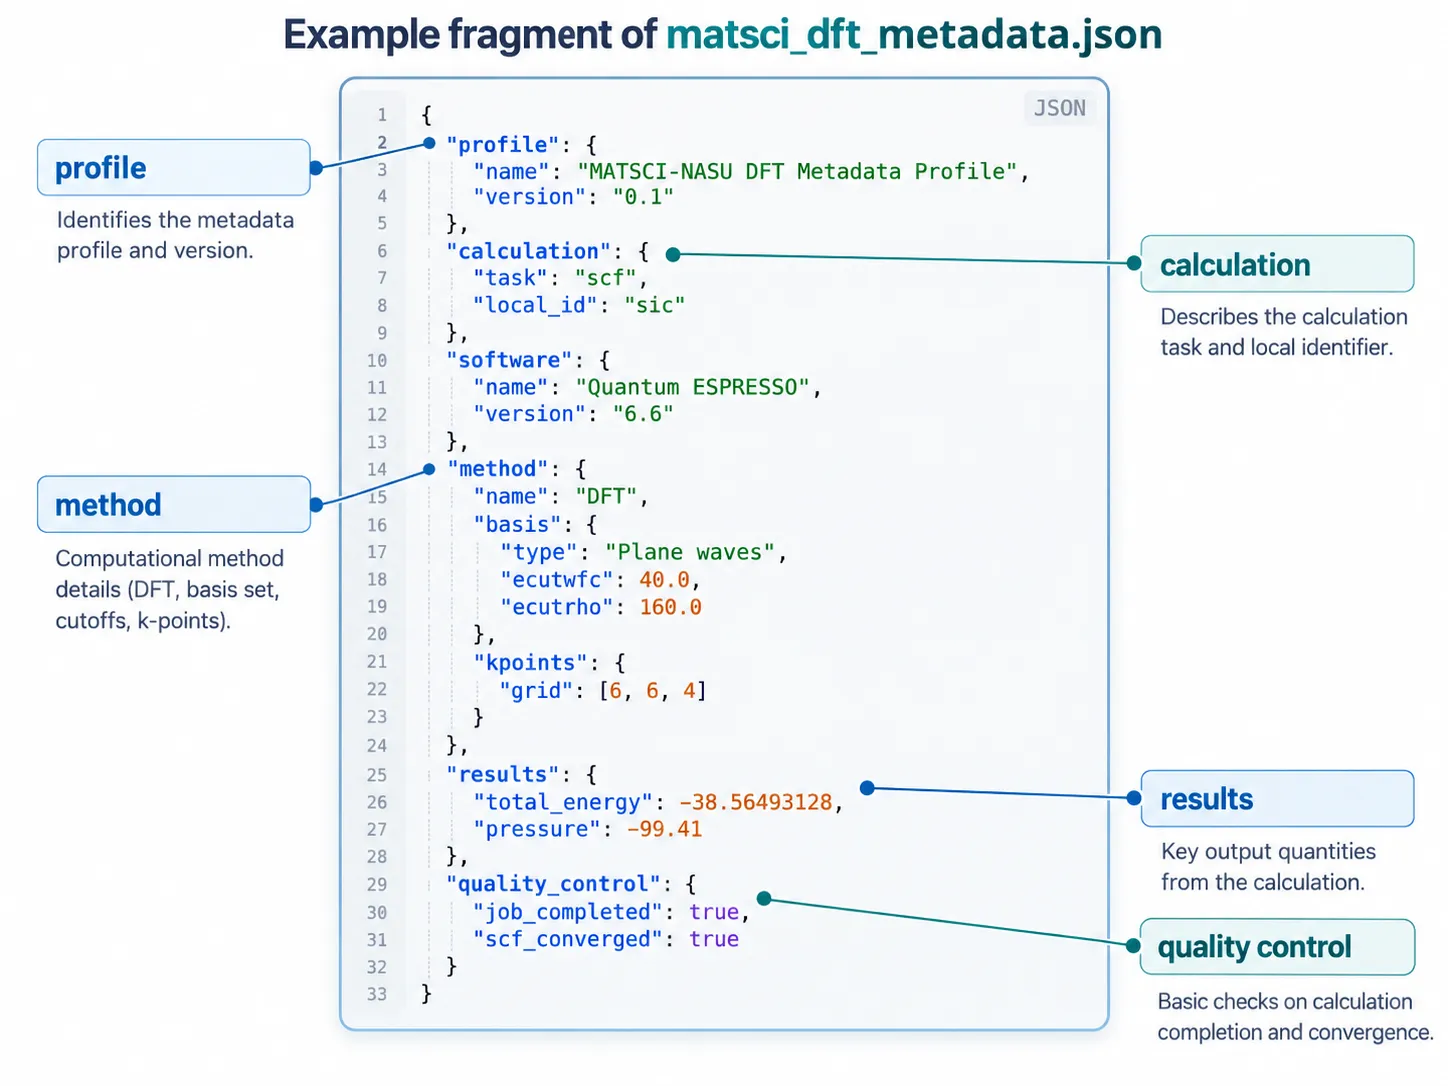
Рис. 3. Приклад фрагмента matsci_dft_metadata.json: основні блоки опису calculation, software, method, results і quality control.
Поділ на окремі логічні блоки дозволяє не змішувати опис того, як був виконаний розрахунок, із тим, які результати він дав. Це також спрощує подальший mapping до MatCore, DataverseUA, RI Catalogue або інших систем.
Як запустити extractor
Для v0.1 достатньо Python 3. Сторонні Python-пакети для базового запуску не потрібні.
Code block
python matsci_dft_extractor.py path/to/calculationабо
python matsci_dft_extractor.py path/to/calculation -o path/to/output_metadataЗа замовчуванням результати записуються у каталог:
path/to/calculation/metadata/У комплекті також є self_test.py для перевірки базової логіки parser.
Download DFT Extractor v0.1Від Quantum ESPRESSO до MatCore-DFT
MATSCI-NASU використовує власний canonical metadata record, а MatCore-DFT — як один із референтних semantic profiles для computational materials science.
Така схема дозволяє надалі створювати з одного master record кілька представлень:
Quantum ESPRESSO files
        ↓
MATSCI canonical metadata
        ↓
MatCore | DataverseUA | RI Catalogue | NOMAD
Це дозволяє не прив’язувати весь workflow до одного конкретного metadata format.
Що формується автоматично, а що залишається куратору
Автоматично доцільно отримувати:
software і version; calculation task; структуру; cutoffs; k-points; SCF parameters; pseudopotential identifiers; energies; forces; stresses; convergence status; checksums.
Куратор або автор додає:
scientific title; purpose; authors і ORCID; affiliations; licence; relation to publication or project; interpretation of the dataset; reuse conditions.
Таким чином FAIRification не перетворюється на велику ручну анкету.
Поточний статус і наступні кроки
Версія 0.1 є prototype for validation, а не production software.
Наступні кроки передбачають:
- перевірку на реальному MATSCI-NASU SiC calculation;
- повний mapping data-file-schema.xml;
- використання qeschema;
- reconstruction relax/vc-relax trajectories;
- normalization controlled vocabularies;
- підтримку multi-calculation workflows;
- підготовку DataverseUA deposit package.
Основні джерела
Тут уже ставити короткий список із 4–5 джерел:
- Quantum ESPRESSO documentation;
- QEF qeschemas;
- QEF qeschema;
- Unified Pseudopotential Format;
- MatCore 0.3.0.
Related RI objects
Services
- FAIR пакування наборів даних обчислювальних матеріалів
- Підтримка метаданих та DOI для даних про матеріали
- Підтримка README та DMP для користувачів ДІ
- Підтримка робочого процесу DFT для дослідження матеріалів
- Підтримка розробки пілотних варіантів використання
- Підтримка планування обчислювальних робочих процесів
Resources
- FAIR checklist for materials datasets
- Quantum ESPRESSO
- Робочі процеси моделювання металевих систем
- Metadata checklist для наборів даних матеріалів
- Шаблон README для наборів даних обчислювальних матеріалів
- Профіль набору даних обчислювальних матеріалів